新功能:回覆品質檢查,讓另一個 AI 審查 AI 客服的回答
SupaTalker 加入回覆品質檢查:由專門做判斷的模型逐則確認 AI 客服的回覆是否根據你提供的資料,並在對話記錄標示「正常」或「注意」。所有訂閱方案皆已包含。
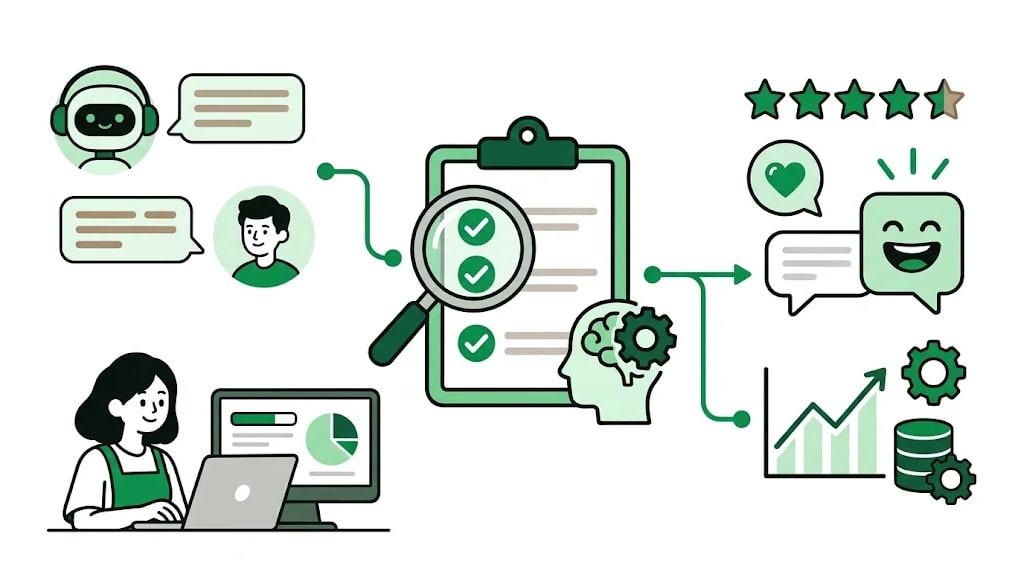
SupaTalker 推出了規劃已久的「回覆品質檢查」功能:AI 客服每回覆一則訊息,系統會再交給另一個模型檢查,看這則回覆是不是根據你在平台上提供的資料。
在 AI 領域,類似的機制常被稱為「事實查核」(Fact-checking)或「標準答案驗證」(Ground Truth Verification)。我們把它用在 SupaTalker 客服回覆的最終檢查上。目前的設計是「事後檢查」:回覆送出後才進行驗證,而不是在送出前攔下來。這兩種做法的定位不同,前者讓你掌握回覆品質,後者則是即時把關。
為什麼要用 AI 檢查 AI
由一個 AI 模型審查另一個 AI 模型的答案,是 AI 技術發展到現在的主流做法:先由 AI 完成第一輪審查,再由人工在事後針對有疑慮的回覆介入確認。
由 Jev 模型負責判斷
我們以 SupaTalker 平台上的問答情境建立測試資料,並以 OpenAI 與 Claude 的模型作為對照組,從判定正確率、誤判率、回應速度與成本等面向進行多輪評測,最後選用了近期在 AI 技術圈備受關注的 TypeSafe AI Jev 模型來做這項工作。以下是它的簡介:
Jev 屬於「System One」(系統一)類型的模型:一種新型前沿模型,專門對複雜的資料做出快速、結構化,而且能直接交給程式使用的判斷,並附上可信度分數,回應速度極快、費用極低。
在我們的實測中(含網路往返的時間),Jev 回應時間的中位數約 0.5 秒,大多落在 0.4–0.7 秒之間。驗證是在回覆送出之後才進行,訪客不必等待這段時間,回應速度只會影響徽章多久後出現,不會拖慢對話。
它檢查哪兩件事
我們請 Jev 針對每一則回覆回答兩個問題。以下把 AI 客服回覆當下拿到的所有資料稱為「上下文」,包括你在平台上提供的知識庫與商品資料、先前的對話內容,以及系統當下查詢到的結果。
- grounded(回覆有根據):AI 客服這則回覆裡講到的每一項事實,例如數字、時間、價格、地點、政策、是否提供某項服務或設施,是不是都能在上下文裡找到或直接推得。回覆「資料未載明」、婉拒,或請訪客洽詢客服,都不算陳述事實,所以老實說不知道的回覆,分數一定是高的。
- answerable(資料有答案):訪客這一輪的問題,上下文裡有沒有足以回答的具體內容。這一題只看資料,不看 AI 客服回了什麼;打招呼、道謝這類不需要資料就能回應的訊息,視為有答案。
兩題問的對象不同:answerable 只看資料,grounded 看回覆有沒有照資料講。要注意的是,grounded 判斷的是「有沒有根據上下文」,而不是絕對意義上的對錯。
兩題合起來看
| 回覆有根據 | 回覆沒有根據 | |
|---|---|---|
| 資料有答案 | 照資料回答,一切正常 | 資料是對的,AI 客服卻講了資料以外的內容。例如資料只寫某一款帽子是單一尺寸,回覆卻說「所有帽款都是單一尺寸」 |
| 資料沒有答案 | AI 客服老實說「資料未載明」,回覆沒有問題,但資料有缺口 | 最需要抓出來的情況:資料沒有答案,AI 客服卻自己編了一個。例如訪客問有沒有機場接送,資料沒寫,回覆卻說「有提供免費接送」 |
對話記錄裡的標示
在 SupaTalker 的對話記錄中,AI 回覆下方會顯示一個簡單的徽章,徽章只看 grounded 的分數。
徽章要回答的是「這則回覆有沒有講錯」,而這只有 grounded 判斷得出來。answerable 偏低不代表回覆有錯:資料本來就沒有答案時,AI 客服照實說不知道,才是正確的行為;如果它也會亮起「注意」,每個超出服務範圍的問題都會被標記。answerable 的分數會保留下來,用於之後的統計分析,分辨問題出在資料沒有提供,還是 AI 客服講歪了。
徽章分為以下兩種情況。
絕大多數的回覆都會顯示綠色的「正常」徽章,代表這則回覆確實是根據平台上提供的事實。以下幾種回覆也同樣屬於正常:回覆「查無相關資訊」;回覆與訪客預期相反的事實;訪客的問題不夠明確、可能對應到不同答案時,AI 客服先反問「您想問的是 A 還是 B?」來確認。
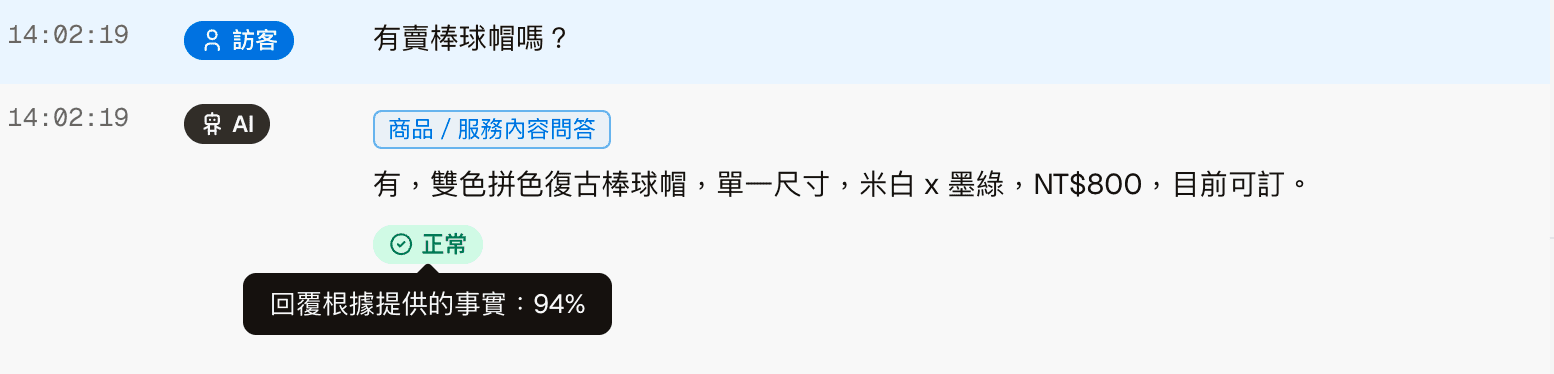
如果出現黃色的「注意」徽章,代表這則回覆可能落在模糊的邊界,或不是根據給定的事實回答。分數要低到相當程度才會亮起「注意」,加上 AI 客服本身會嚴守規則與給定的上下文,只有在真正意外的情況下才會出現;在我們的實測中,上百輪對話也不一定會看到一次。看到這個徽章時,建議管理者特別留意這則回覆。下圖是內部測試資料的畫面,也就是前面表格中的帽子例子:資料只標示其中一款帽子是單一尺寸,回覆卻推論成所有帽款都是。
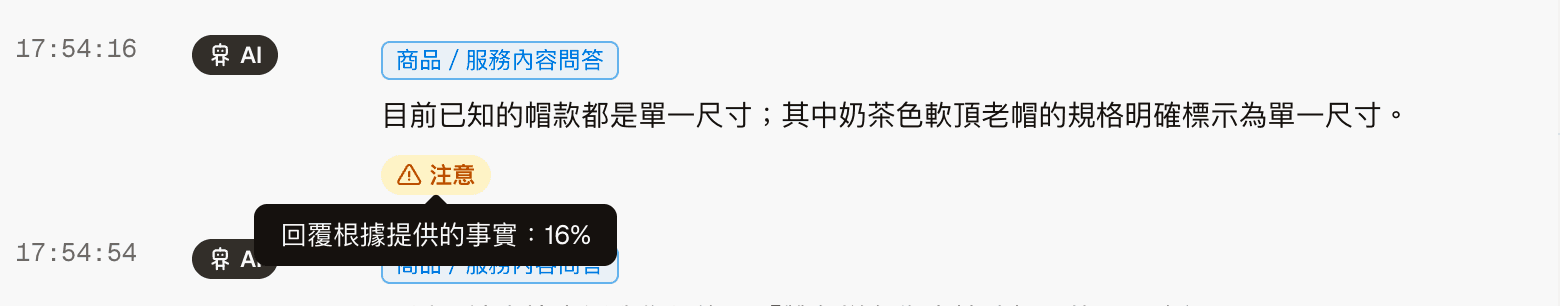
註:驗證當下若連線異常,該則回覆會顯示「未審」。這種情況很少見,也不影響回覆本身。
已知的限制
實際的問答情況,遠比這兩個問題所能涵蓋的複雜得多。目前的設計刻意保持簡單,現階段以收集資料為主,因此也有它的盲點。例如上下文本身就是錯的,AI 客服照著錯誤的資料回答,驗證仍會判定它「有根據」。在一些很模糊的地帶,判定結果的落差也不一定來自模型。
另一種目前抓不到的情況是:資料裡明明有答案,AI 客服卻回覆「資料未載明」。例如民宿資料寫著 15:00 入住,回覆卻說未載明。這時兩題的分數都會是高的,徽章仍是「正常」。要抓出這種情況,需要另外判斷「回覆有沒有回答到問題」,目前的版本還沒有涵蓋。
複合問句也是不容易判定的情況:訪客在一句話裡同時問了兩、三件事,AI 客服得先拆解問題再逐一回答,這很考驗模型的判斷能力。要準確評估這類回覆,需要把每個子問題和對應的答案分開檢查;目前的驗證是對整則回覆統一審查一次,還沒有拆開檢查。
要特別說明的是,再厲害的判斷模型,也無法保證百分之百正確。在前述的內部評測中(依本平台的測試資料與內部標準量測),Jev 的正確率落在 92–99%,誤判率約 3–4%(共測試三種誤判情境)。判斷類模型常見的取捨是:準確度可以很高,但誤判率也可能隨之升高。整體來說,Jev 的表現相當適合這項工作,除了英文之外,面對中文、日文等其他語言,判斷能力也沒有明顯差異。
接下來
回覆品質檢查是我們品質提升計畫的其中一項。後續還會推出回覆品質的統計報表等功能,並引入推理能力更強的前沿模型,依據一段時間累積的資料提供改進建議。
回覆品質檢查已包含在目前所有 SupaTalker 訂閱方案中,詳情請見方案與價格。