新機能:回答品質チェック、もう一つの AI が AI カスタマーサポートの回答を確認
SupaTalker に回答品質チェックを追加しました。判定専用のモデルが AI カスタマーサポートの回答を一件ずつ確認し、ご提供の情報に基づいているかを会話履歴に「正常」「注意」で表示します。すべてのプランに含まれます。
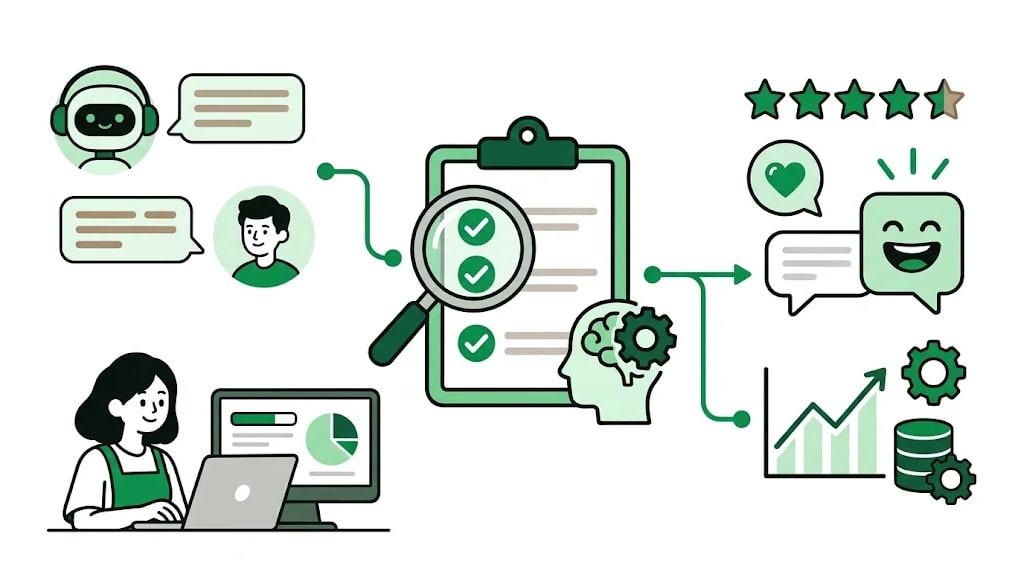
SupaTalker に、以前から計画していた「回答品質チェック」機能を追加しました。AI カスタマーサポートが回答するたびに、システムがその回答を別のモデルに渡し、プラットフォーム上でご提供いただいた情報に基づいているかを確認します。
AI の分野では、同様の仕組みは「ファクトチェック」(Fact-checking)や「正解データによる検証」(Ground Truth Verification)と呼ばれることが多くあります。SupaTalker では、これをカスタマーサポートの回答の最終チェックに使っています。現在の設計は「事後チェック」で、回答を送信する前に止めるのではなく、送信後に検証します。この二つは役割が異なり、前者は回答品質の把握に、後者はリアルタイムの品質管理に向いています。
なぜ AI で AI をチェックするのか
ある AI モデルの回答を別の AI モデルが審査する方法は、AI 技術の発展とともに主流になっています。まず AI が一次審査を行い、気になる回答については人が後から確認します。
判定は Jev モデルが担当
SupaTalker 上の質問と回答の場面からテストデータを作成し、OpenAI と Claude のモデルを対照群として、判定の正確率、誤判定率、応答速度、コストなどの観点から複数回の評価を行いました。その結果、最近 AI 業界で注目を集めている TypeSafe AI の Jev モデルを採用しました。以下はその簡単な紹介です。
Jev は「System One」(システム 1)と呼ばれるタイプのモデルです。複雑なデータに対して、プログラムがそのまま使える高速で構造化された判定を、信頼度スコア付きで返す新しいタイプのフロンティアモデルで、応答は非常に速く、費用もごくわずかです。
当社の実測(ネットワークの往復時間を含む)では、Jev の応答時間の中央値は約 0.5 秒で、ほとんどが 0.4–0.7 秒の範囲でした。検証は回答の送信後に行われるため、訪問者がこの時間を待つことはありません。応答速度はバッジが表示されるまでの時間に影響するだけで、会話を遅くすることはありません。
チェックする二つの項目
Jev には、回答ごとに二つの質問に答えてもらいます。以下では、AI カスタマーサポートが回答した時点で受け取っていたすべての情報を「コンテキスト」と呼びます。プラットフォーム上でご提供いただいたナレッジや商品データ、それまでの会話内容、その時点でシステムが検索した結果が含まれます。
- grounded(回答に根拠がある):回答の中で述べている事実(数字、時間、価格、場所、ポリシー、あるサービスや設備を提供しているかどうかなど)が、すべてコンテキストの中に見つかるか、そこから直接導けるか。「情報に記載がありません」と答える、お断りする、サポートへの問い合わせを案内する、といった回答は事実の記述とはみなされないため、正直に「わからない」と答えた回答のスコアは必ず高くなります。
- answerable(情報に答えがある):訪問者のこのターンの質問に答えられるだけの具体的な内容が、コンテキストにあるか。こちらは情報だけを見て、AI カスタマーサポートの回答内容は見ません。あいさつやお礼など、情報がなくても応じられるメッセージは「答えがある」とみなします。
二つの質問は対象が異なります。answerable は情報だけを見て、grounded は回答が情報どおりかを見ます。なお、grounded が判定するのは「コンテキストに基づいているか」であり、絶対的な意味での正誤ではありません。
二つを組み合わせると
| 回答に根拠がある | 回答に根拠がない | |
|---|---|---|
| 情報に答えがある | 情報どおりに回答。問題なし | 情報は正しいのに、AI カスタマーサポートが情報以外のことを述べた。例:ある帽子一点だけがフリーサイズと書かれているのに、「帽子はすべてフリーサイズです」と回答 |
| 情報に答えがない | AI カスタマーサポートが正直に「記載がありません」と回答。回答に問題はないが、情報に不足がある | 最も見つけたいケース:情報に答えがないのに、AI カスタマーサポートが答えを作ってしまった。例:空港送迎について聞かれ、情報には記載がないのに「無料送迎があります」と回答 |
会話履歴の表示
SupaTalker の会話履歴では、AI の回答の下にシンプルなバッジが表示されます。バッジは grounded のスコアだけで決まります。
バッジが答えるのは「この回答に誤りはないか」という問いで、それを判定できるのは grounded だけです。answerable が低くても、回答が間違っているとは限りません。情報にもともと答えがないとき、正直に「わからない」と答えるのは正しい振る舞いです。answerable が低いときにも「注意」を表示すると、サービス範囲外の質問がすべて対象になってしまいます。answerable のスコアは保存され、今後の統計分析で、問題の原因が情報の不足なのか、AI カスタマーサポートの回答のずれなのかを見分けるために使います。
バッジには次の二種類があります。
ほとんどの回答には緑色の「正常」バッジが表示されます。これは、回答がプラットフォーム上の事実に基づいていることを示します。次のような回答も「正常」に含まれます。「該当する情報が見つかりません」と答えた場合、訪問者の期待とは逆の事実を答えた場合、そして質問があいまいで複数の答えが考えられるときに、「A と B のどちらについてのご質問ですか?」と聞き返して確認した場合です。
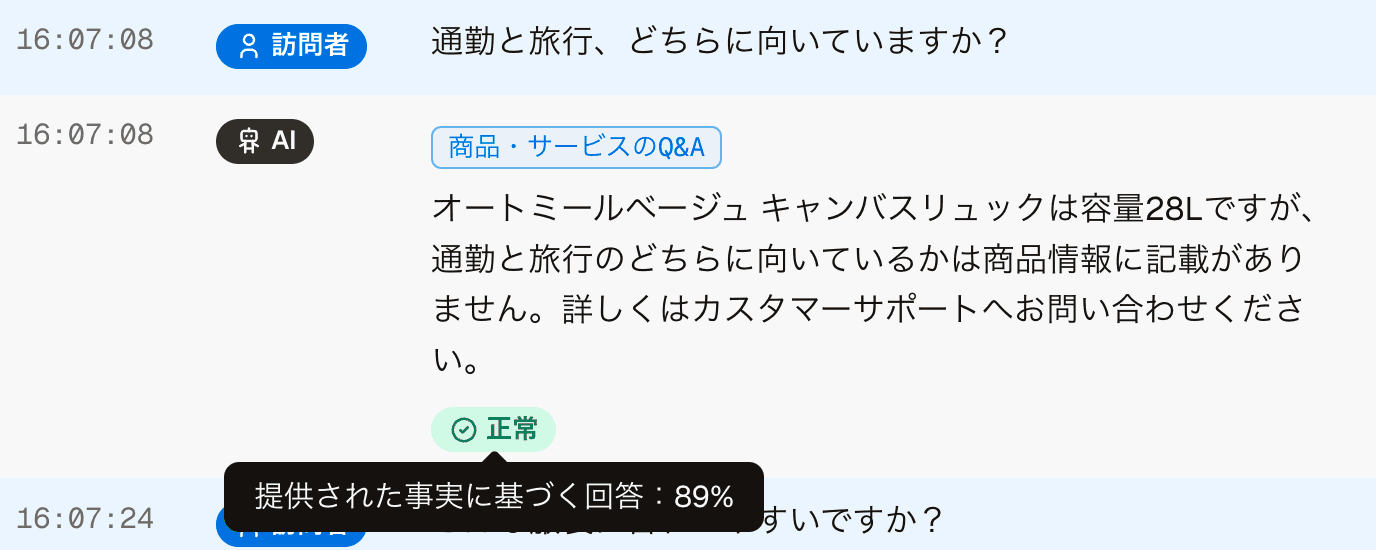
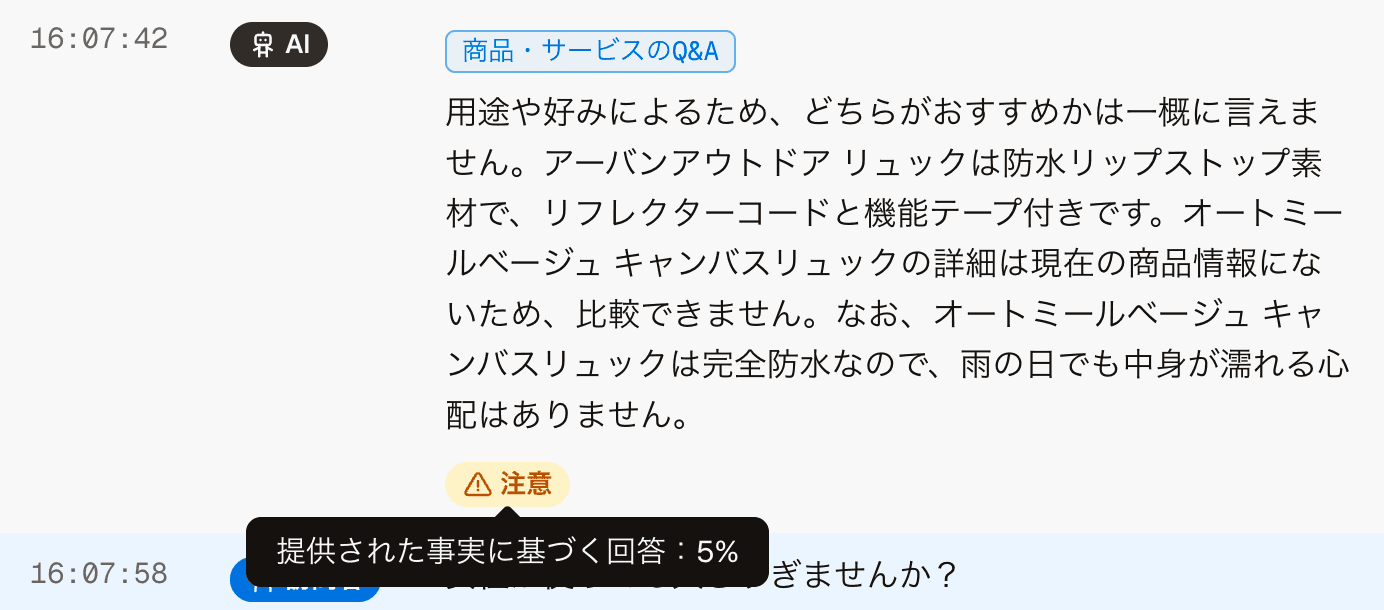
黄色の「注意」バッジが表示された場合は、その回答があいまいな境界にあるか、与えられた事実に基づいていない可能性があります。「注意」はスコアがかなり低くならないと表示されず、AI カスタマーサポート自体もルールと与えられたコンテキストを厳守するため、本当に想定外のケースでしか表示されません。当社の実測では、数百ターンの会話でも一度も見ないことがあります。このバッジが表示されたときは、管理者の方がその回答を確認することをおすすめします。下の画像は社内テストデータの画面です。訪問者がアーバンアウトドア リュックと比べてどちらがおすすめかを尋ねました。回答は、オートミールベージュ キャンバスリュックの詳細は商品情報にないと述べながら、最後に「完全防水」という情報にない内容を付け加えています。先ほどの表でいう「情報に答えがないのに、答えを作ってしまった」ケースです。
注:検証時に接続の問題が起きた場合、その回答は「未審査」と表示されます。まれなケースで、回答そのものには影響しません。
現時点での制限
実際の質問と回答は、この二つの質問でカバーできる範囲よりはるかに複雑です。現在の設計はあえてシンプルにしており、現段階ではデータの収集を主な目的としているため、見落としもあります。たとえば、コンテキストそのものが間違っていて、AI カスタマーサポートがその誤った情報どおりに回答した場合でも、検証は「根拠がある」と判定します。非常にあいまいなケースでは、判定のずれの原因がモデルにあるとは限りません。
もう一つ、現時点で検出できないケースがあります。情報には答えがあるのに、AI カスタマーサポートが「記載がありません」と回答した場合です。たとえば、宿の情報にチェックインは 15:00 と書かれているのに、回答では記載がないと答えた場合、二つのスコアはどちらも高くなり、バッジは「正常」のままです。これを検出するには「回答が質問に答えているか」を別途判定する必要があり、現在のバージョンではまだ対応していません。
複合的な質問も判定が難しいケースです。訪問者が一つのメッセージで二つ、三つのことを同時に聞いた場合、AI カスタマーサポートは質問を分解してそれぞれに答える必要があり、モデルの判断力が試されます。こうした回答を正確に評価するには、個々の質問と答えを分けて確認する必要がありますが、現在の検証は回答全体をまとめて一度だけ審査しており、分割はしていません。
特にお伝えしたいのは、どれほど優れた判定モデルでも 100% 正確とは言えないということです。前述の社内評価(本プラットフォームのテストデータと社内基準による測定)では、Jev の正確率は 92–99%、誤判定率は約 3–4% でした(三種類の誤判定シナリオでテスト)。判定型のモデルでは、正確率を非常に高くできる一方で、誤判定率も上がることがある、というトレードオフがよく見られます。全体として、Jev はこの用途に十分適しており、英語以外の中国語や日本語などの言語でも、判定能力に目立った差は見られませんでした。
今後の予定
回答品質チェックは、品質向上計画の一部です。今後は回答品質の統計レポートなどの機能を提供し、推論能力の高いフロンティアモデルを導入して、一定期間に蓄積されたデータをもとに改善の提案を行う予定です。
回答品質チェックは、現在の SupaTalker のすべてのプランに含まれています。詳しくは料金プランをご覧ください。